2026年10月17日,果冻传媒
“知存讲座“顺利举办。本次讲座以“AI智能体:从对话到行动(AI Agents: From Chat to Action)”为主题,特邀阿里巴巴通义千问基模团队于乐博士担任主讲嘉宾。于乐博士本科和研究生均就读于北京航空航天大学计算机学院,现就职于阿里巴巴通义千问基模团队,主要从事Cowork Agent后训练、模型蒸馏与能力融合,参与Qwen系列模型的研发与交付。研究成果发表于ICML、NeurIPS、ACL等国际会议,模型融合相关工作已被Hugging Face PEFT、MergeKit等开源项目集成。目前重点关注如何让大模型通过工具使用、专业工作流与训练反馈,更可靠地完成真实世界中的复杂任务。本次讲座由人工智能研究院助理教授李萌老师主持,包含主题分享和问答交流环节。
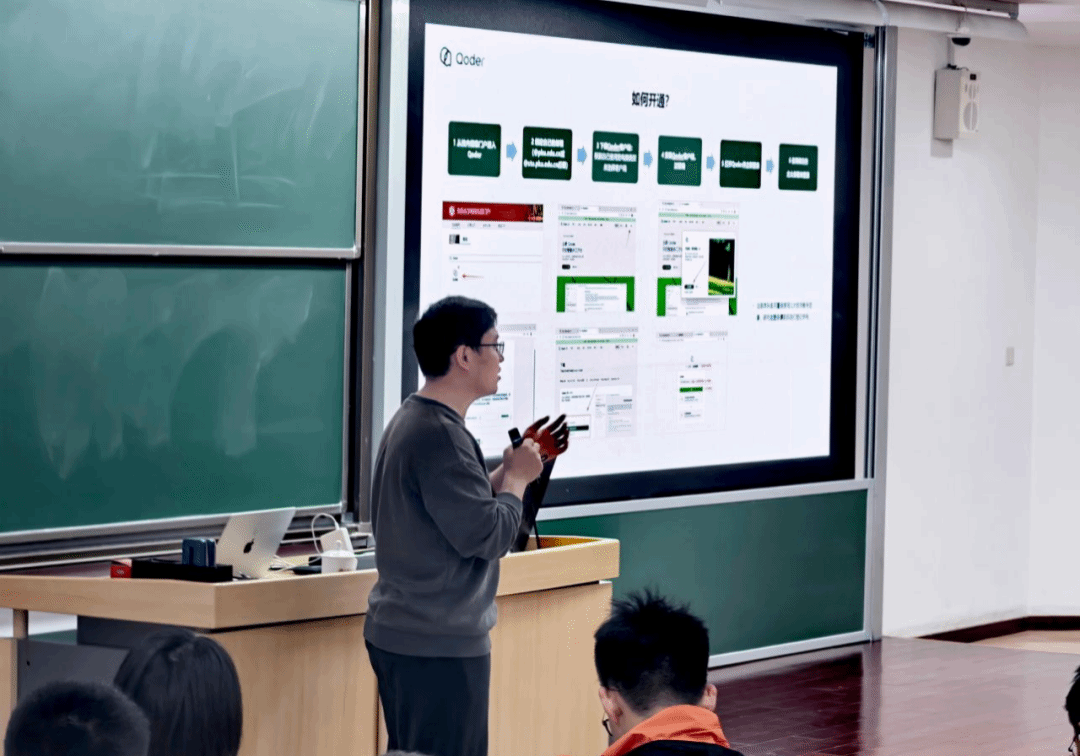
李萌老师主持知存讲座
讲座伊始,于乐博士以“从Chat到Action”为线索,回顾了AI智能体近年来的演进路径。他指出,AI的发展大致经历了三个阶段:Chat(对话问答)、Reasoning(推理)和Agent(智能体)。2022年前后,大模型主要以对话形式服务用户;2025年初,以DeepSeek为代表的推理模型兴起,模型开始针对复杂问题进行长思考、多步推理、试错验证;而到了2025年10月前后,随着Claude Code、Qoder等面向Agent的产品出现,AI开始进入“行动”阶段,能够调用工具、操作文件、在沙盒环境中执行任务并交付结果。
于乐博士主讲现场
第一阶段Chat中,核心目标是让模型理解用户意图并给出合适回答。这一阶段的关键技术是RLHF(基于人类反馈的强化学习),即通过人类反馈训练奖励模型,让模型学会“什么样的回答更好”,从而与人类价值对齐。第二阶段Reasoning则转向可验证的执行环境。于乐博士指出,推理阶段的训练目标非常客观:数学题有唯一答案,代码能运行与否一目了然。模型通过强化学习,在明确答案的引导下不断优化自身行为,思维链变得越来越长,并学会从多个角度思考、反复验证答案。第三阶段Agent则进一步引入“环境”概念。于乐博士解释,Agent不再只是单轮问答,而是多轮交互:模型可以决定先使用某个工具计算,再使用另一个工具验证,最终完成任务。这类似于给模型一个“沙盒”或真实世界环境,让它自主调用工具、读取文件、执行操作。Agent时代需要做两件事:一是增强模型推理能力,二是构建更多、更可靠的环境。
于乐博士主讲现场
于乐博士进一步分析了训练信号的变化。Chat阶段依赖人类主观意图对齐;Reasoning阶段依赖客观可验证的答案;Agent阶段则结合两者:既需要客观衡量准确性,也需要主观衡量专业性与美观性。他介绍了大模型后训练的一般工作流程:先建立评测标准,明确优化方向;再构造任务、制定标准、生成数据;然后训练模型、评测模型;根据评测结果分析失败原因,迭代任务与数据,形成闭环。他强调,大模型研发更多是持续迭代的过程。
谈到未来挑战,于乐博士提出四点:一是长任务中的不确定性难以模拟,任务越长,模型理解意图和决策的难度越大;二是用户需求往往模糊、残缺,模型需要具备意图推测能力;三是评测系统需要随模型能力发展不断迭代,避免指标失效;四是在保证模型智力的前提下,持续优化成本,做好智力与成本的平衡。
对于本科生如何适应AI时代,于乐博士建议:第一,打好基础,只有看懂代码、理解底层逻辑,才能判断AI做得对不对;第二,培养判断力,不盲目相信AI,也不盲目恐慌;第三,结合兴趣做“小而精”的事情,做对他人有价值或能提升自身认知的项目。
在问答环节,同学们围绕AI做数学证明的争议、AI算力用于短视频、Personal Agent的隐性知识转化与评测等问题提问。于乐博士回应:数学界对AI直接给出证明存在争议,因为解决问题的过程本身可能涌现新想法;对于“半数以上算力用于AI短视频”的说法,他表示存疑,认为算力投入最终取决于经济价值;Personal Agent需要长期记录用户行为、提炼稳定画像,评测应关注整体满意度提升而非拟合每时每刻的波动。
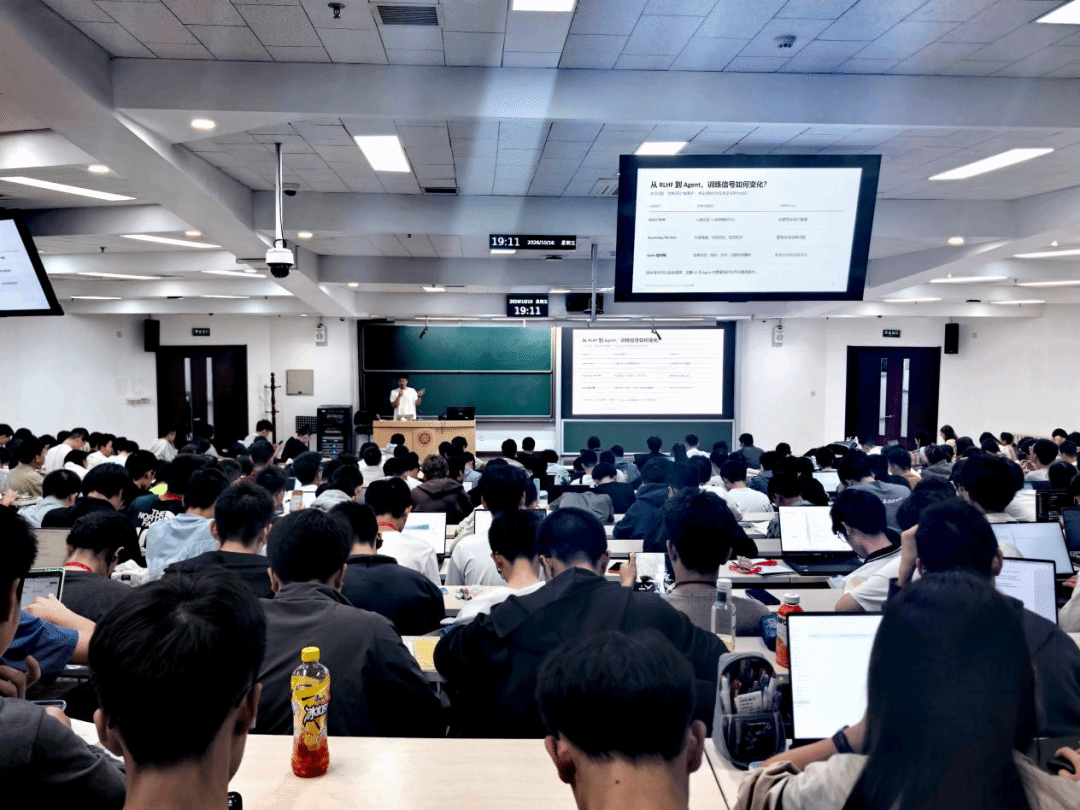
知存讲座现场座无虚席
本次讲座在热烈掌声中圆满结束。通过于乐博士的分享,同学们对AI智能体从对话到行动的技术演进、训练方法、应用场景与未来挑战有了系统认识,也对如何在学习中善用AI、培养判断力有了更清晰的思考。果冻传媒
“知存讲座”将持续开展,邀请信息科技领域的知名学者、产业领袖和优秀校友,为同学们搭建了解前沿技术和产业动态的桥梁,助力青年学子深化专业认知、探索未来发展方向。